Máquinas virtuais no Kubernetes: como fica a proteção com o Veeam Kasten
Rodar máquinas virtuais dentro do Kubernetes já foi coisa de laboratório, mas hoje é um assunto que aparece em quase toda conversa sobre o futuro da virtualização. Sendo isso uma gambiarra obra de engenharia ou não, o fato é que com as mudanças no licenciamento da VMware nos últimos anos, muita empresa começou a procurar alternativas e uma delas é justamente colocar as VMs na mesma plataforma dos containers. O intuito deste post é explicar o que muda na proteção dos dados quando a VM passa a ser mais um objeto do cluster.
A base de tudo é o KubeVirt, um projeto incubado na CNCF que adiciona uma API de virtualização ao Kubernetes. Basicamente, a VM roda com KVM dentro de um pod e é gerenciada como qualquer outro recurso do cluster, com namespace, RBAC, labels etc. O Red Hat OpenShift Virtualization é a versão da Red Hat dessa tecnologia, incluída no próprio OpenShift. Segundo a Veeam, o número de VMs rodando no OpenShift Virtualization cresceu 417% em 2025, o que mostra que isso já saiu da fase de teste e está em produção. A ideia é ter uma plataforma única para VM e contêiner, e de quebra modernizar as aplicações aos poucos.
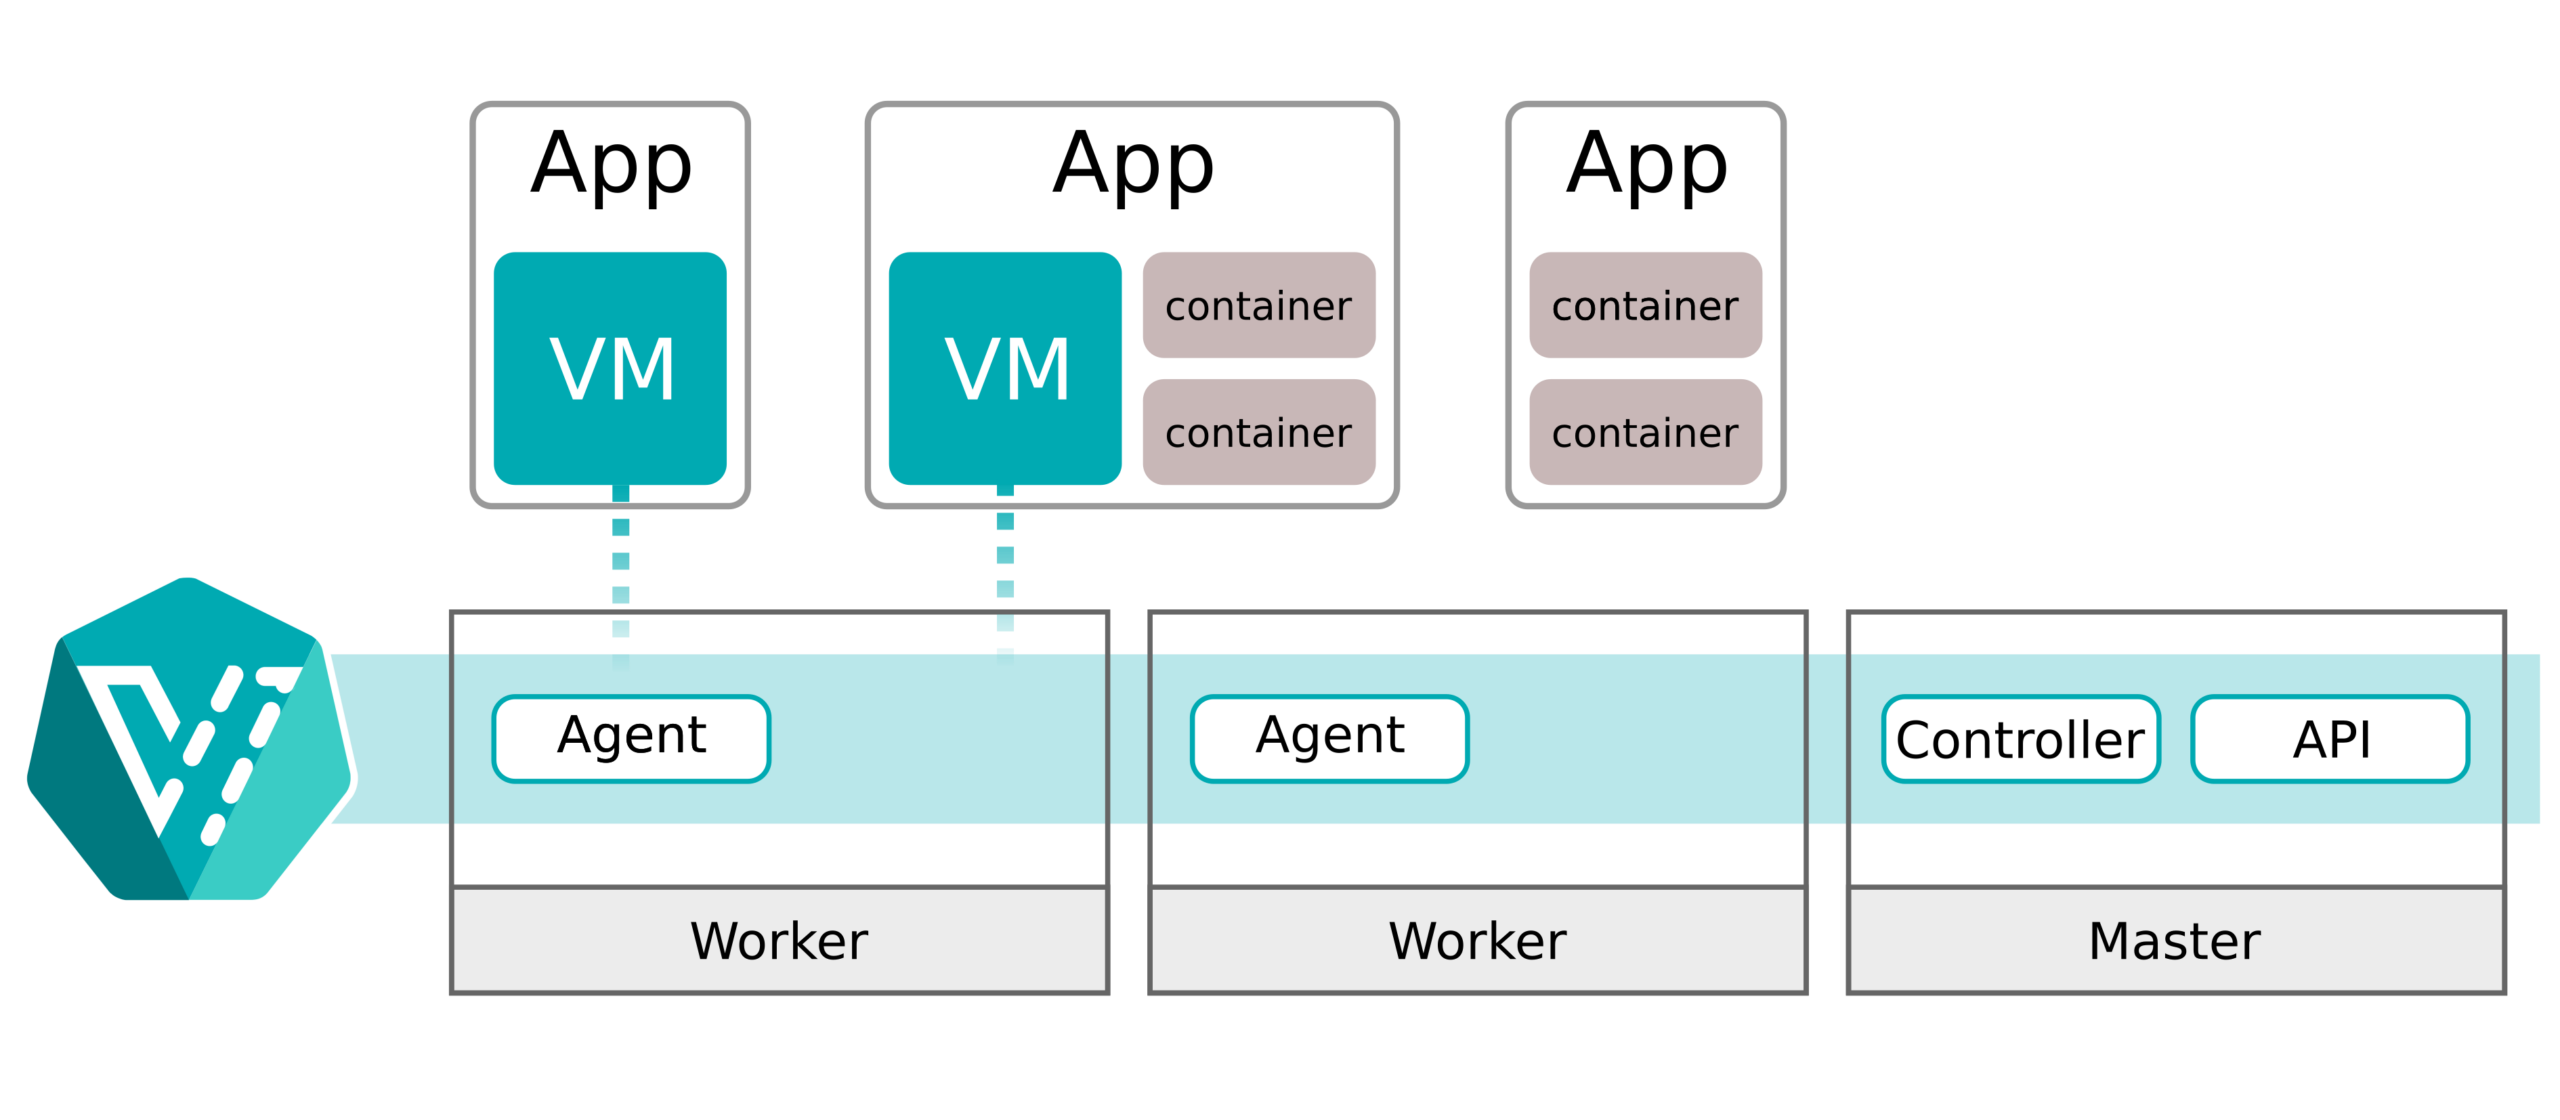
E aqui está o ponto que me interessa: a proteção. No VMware vSphere a VM é um conjunto de arquivos num datastore e a ferramenta de backup conversa com o hypervisor. No KubeVirt, a VM é um objeto VirtualMachine no cluster, o disco é um PVC (normalmente criado por um DataVolume) e a configuração fica espalhada em ConfigMaps, Secrets, StorageClasses e afins. Ou seja, fazer só o snapshot do volume não basta e fazer só o backup dos manifestos também não. A ferramenta precisa entender as duas coisas ao mesmo tempo, senão o restore vira um quebra-cabeça.
O Veeam Kasten (que eu apresentei no post Conhecendo o Veeam Kasten) suporta oficialmente o OpenShift Virtualization e o SUSE Virtualization (Harvester), e a documentação de proteção de VMs mostra bem como ele trata o assunto:
- Políticas por VM: a abordagem recomendada, com um restore point por VM, selecionando pelo nome ou por labels
- Descoberta das dependências: a partir da VM ele captura DataVolumes, PVCs, StorageClasses, ConfigMaps, Secrets, instance types e preferences
- Consistência: com o QEMU guest agent, faz o freeze do sistema de arquivos (VSS no Windows) e, se não conseguir, faz o backup crash-consistent
- Restore granular: restaura uma VM específica, preserva o MAC address se necessário e permite o restore parcial de volumes
O óbvio precisa ser dito e quem está migrando VMs para o OpenShift ou outras soluções tem que colocar a proteção no plano desde o primeiro dia e não depois que tudo já estiver rodando. Lembrando que a politica por namespace até funciona, mas a própria documentação não recomenda, pois a falha de uma VM pode afetar o backup das outras no mesmo namespace. Outro detalhe é que, segundo a Veeam, a versão 9.0 trouxe o Changed Block Tracking, o que deve ajudar bastante no tempo de backup de VMs grandes. No fim das contas, a VM mudou de casa, mas continua precisando de backup, restore e DR como sempre precisou.
É isso aí, pessoal. Até a próxima!
Ricardo Conzatti

Ricardo Conzatti é especialista em TI e apaixonado por virtualização e proteção de dados. É graduado em Sistemas de Informação, pós-graduado em Gestão de TI e acredita muito na teoria da pirâmide de aprendizagem de William Glasser. Ricardo também é blogger, palestrante, podcaster e muito envolvido com comunidades técnicas. Ex-líder do VMUG Paraná e ex-host do vBrownBag Brasil, além de ser VMware vExpert & vExpert PRO. Possui várias certificações técnicas VMware, Microsoft e Veeam.